Cuando salió GPT-5, los prompts que funcionaban bien con GPT-4 empezaron a dar peores respuestas, y me tocó replantear cómo escribía los míos. El modelo le daba demasiadas vueltas a cosas simples, hacía llamadas a herramientas que nadie le pidió, y el límite de 80 mensajes cada 3 horas te alcanzaba justo cuando más lo necesitabas. En la casa el problema era otro: mi esposa y yo chocábamos con los límites, y la solución obvia era pagar varias suscripciones de $20.
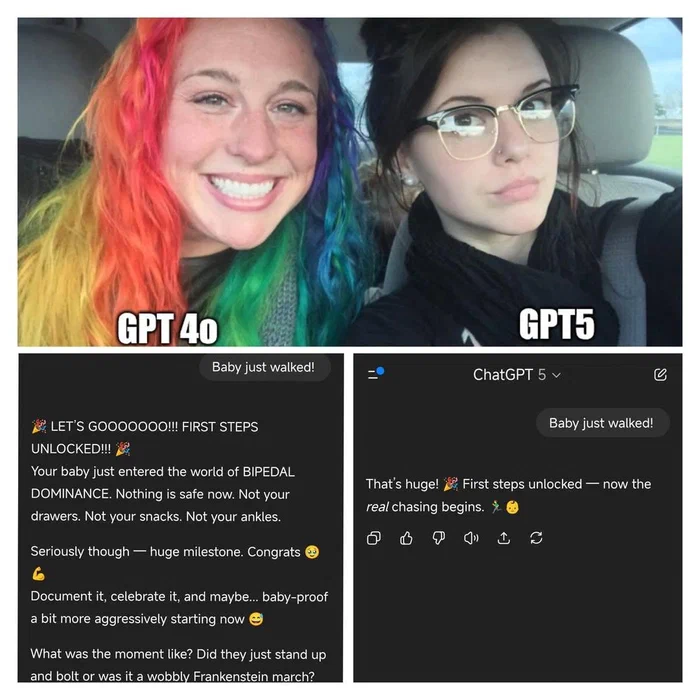
Así que cambié dos cosas. Empecé a estructurar mis prompts como OpenAI dice que GPT-5 los espera, y dejamos de pagar suscripciones para pasarnos a las APIs. De eso se trata este post. El meme resume bastante bien cómo se sintió el lanzamiento:
De suscripciones a APIs #
El plan era pagar dos suscripciones de ChatGPT Plus ($40 al mes) más una de Claude que yo quería probar (otros $20). Eso son $60 al mes, y todavía con límites de uso. Mejor quise ver qué pasaba si usábamos las APIs directo. Así se vio nuestro uso real durante varios meses:
Nuestro mes más pesado fue mayo, con unos $28 entre los dos. La mayoría de meses nos ahorramos entre 60 y 70% frente a las suscripciones.
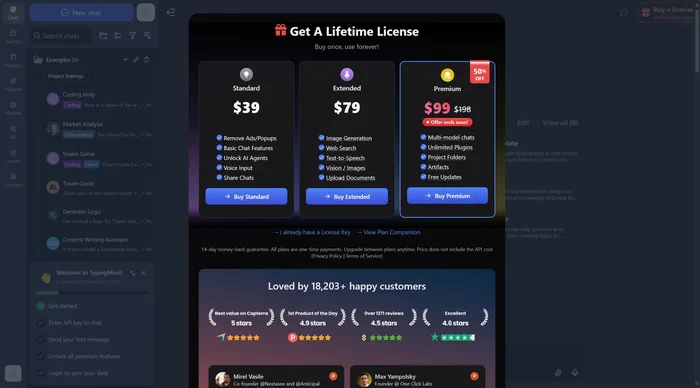
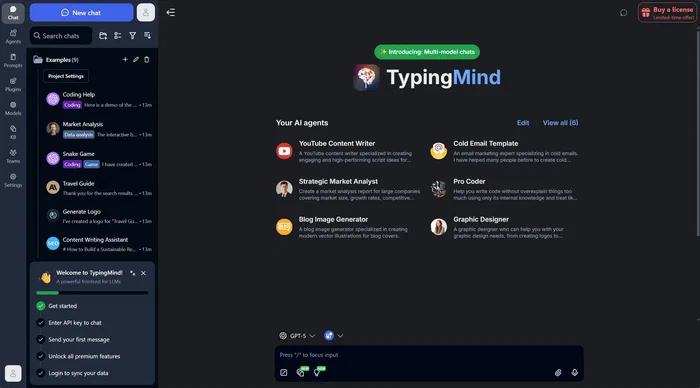
Para el día a día usamos TypingMind ➡️, una interfaz tipo ChatGPT que se conecta a nuestras API keys de OpenAI y Anthropic, así que pasamos de GPT-5 a Claude sin pensarlo. La licencia completa anda por los $99. Yo la compré por menos de la mitad, pero aun a precio completo se paga sola en unos seis meses comparada con una suscripción de ChatGPT.
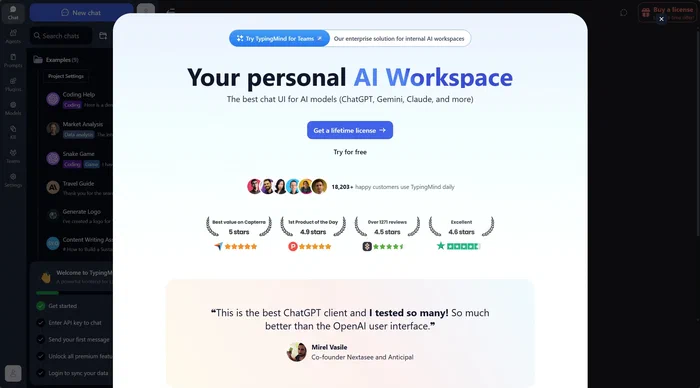
También corro Open-WebUI ➡️ en el servidor de la casa para cuando quiero probar otros modelos u Ollama. Si prefieres experimentar sin gastar nada, empieza por ahí.
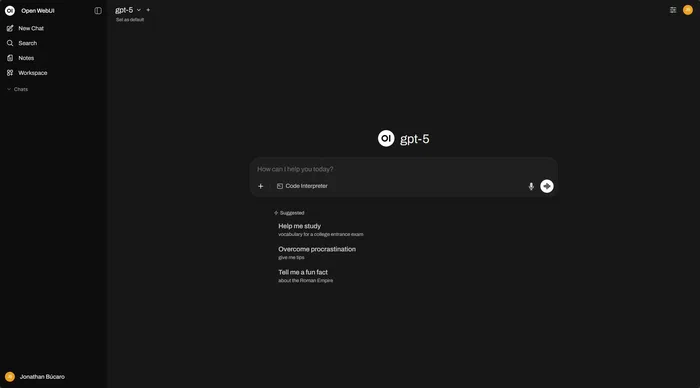
Después de varios meses con esta configuración, preguntamos más porque ya no estamos pendientes de los límites, experimentamos más con distintos modelos y elegimos el modelo según la tarea (GPT-5 para código, Claude para escribir). Seguimos revisando el consumo, pero casi nunca nos preocupa, porque hasta los meses pesados cuestan menos que las suscripciones. Además lo usamos desde cualquier dispositivo, sin el aviso de “actualiza para continuar”, y con un solo historial de conversaciones para todos los modelos.
A cambio, nos toca manejar nuestras propias API keys y la facturación, la configuración inicial toma de 15 a 30 minutos, y perdimos acceso a los custom GPTs de la comunidad.
Actualización: Sam Altman confirmó en X que los suscriptores de ChatGPT Plus van a tener límites más altos. Si ya tienes Plus y estás contento, puede que con eso te alcance. Para nosotros, la flexibilidad de la API y el ahorro siguen teniendo más sentido.
Prompts que funcionan mejor con GPT-5 #
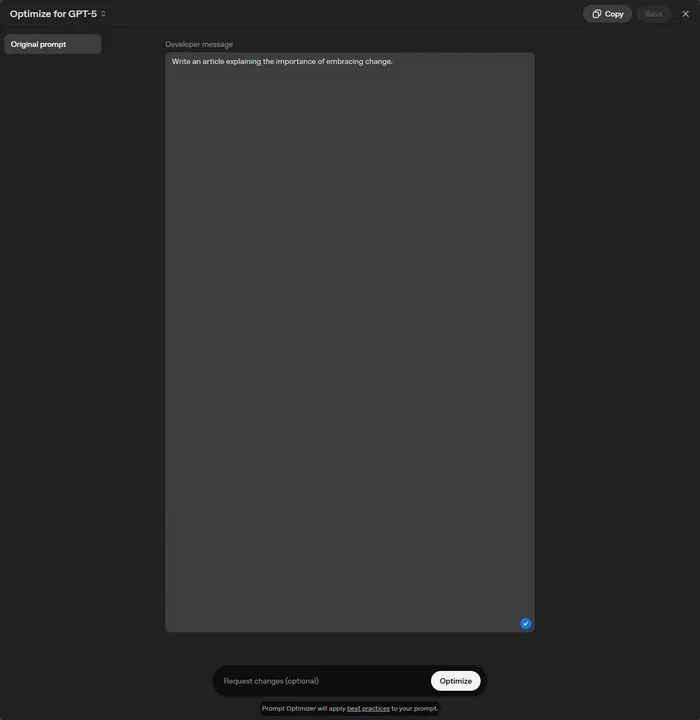
GPT-5 hace lo que le pides, al pie de la letra, entonces le va mejor con prompts que parecen más una especificación que una pregunta casual. El Prompt Optimizer de OpenAI lo deja muy claro: agarra Write an article explaining the importance of embracing change. y lo convierte en siete secciones, desde Role and Objective hasta Stop Conditions. Con razón a la gente le estaba costando.
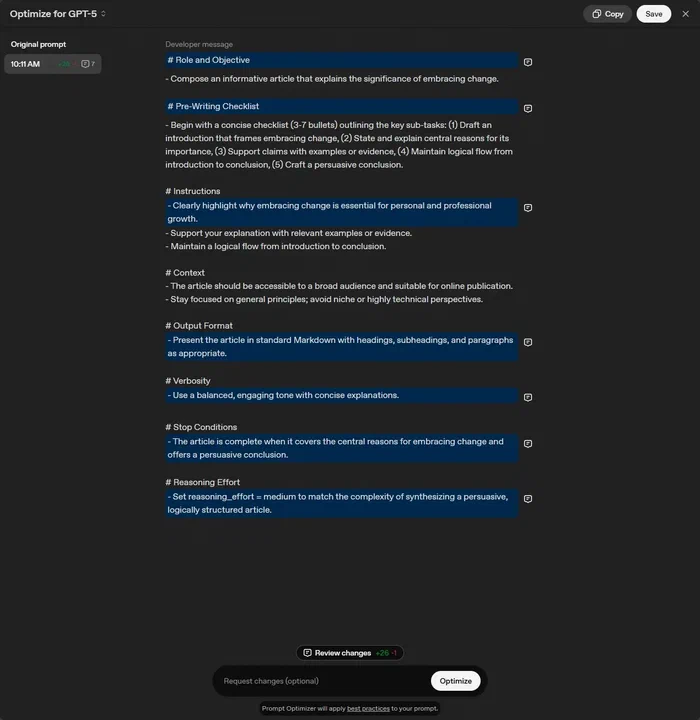
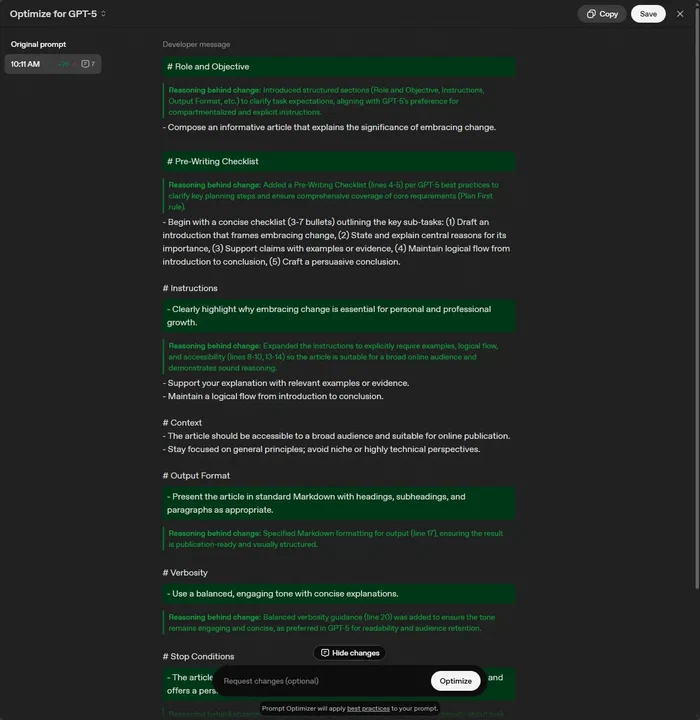
No necesitas las siete en cada prompt. Estos son los cambios que más me sirvieron.
Dale una estructura básica. Objetivo, contexto y requerimientos:
<objective>
Create a Python function that validates email addresses and returns detailed error messages for invalid formats.
</objective>

<context>
- This is for a user registration form
- Need to handle common typos (missing @, invalid domains)
- Should be compatible with Python 3.10+
</context>

<requirements>
- Return True/False for validity
- Include specific error message for each failure type
- Add docstring with examples
- Keep it simple - no external dependencies
</requirements>
Parece más trabajo, pero 30 segundos armando la estructura te ahorran cinco rondas de ida y vuelta. Para una pregunta de dos líneas, no vale la pena.
Dile cuánto pensar. GPT-5 decide cuánto razonamiento aplicar, y muchas veces se pasa con cosas simples:
// Instead of letting GPT-5 overthink this:
"Fix this simple syntax error"

// Be more specific:
"This is a simple syntax fix - focus on speed over analysis"
Para decisiones de arquitectura o bugs complicados, haz lo contrario y pídele que se tome su tiempo con los trade-offs.
Pide análisis antes de la respuesta. Cuando quieres una recomendación, haz que razone primero:
Before providing recommendations:
1. Analyze the current situation and key challenges
2. Evaluate available options against the constraints
3. Consider trade-offs and potential issues
4. Validate the analysis before presenting solutions
Bájale a las mayúsculas. Con los modelos anteriores, el lenguaje enfático ayudaba. Con GPT-5 te sale al revés, y terminas con llamadas a herramientas de más y sobreanálisis. En vez de:
Be THOROUGH when gathering information.
Make sure you have the FULL picture before replying.
You MUST follow these guidelines EXACTLY.
prueba:
Review the codebase structure before making changes.
Consider the existing patterns and maintain consistency.
Follow the established coding conventions.
No te contradigas. Como sigue las instrucciones tan al pie de la letra, una contradicción en .cursor/rules, en AGENTS.md o en la documentación del proyecto se cuela en todas las respuestas. El Prompt Optimizer es bueno para encontrarlas.
Para reglas de código, usa secciones tipo XML. OpenAI lo encontró trabajando con Cursor, y deja clara la jerarquía:
<code_editing_rules>
  <guiding_principles>
    - Every component should be modular and reusable
    - Prefer composition over inheritance
    - Write self-documenting code with clear variable names
  </guiding_principles>

  <frontend_stack_defaults>
    - Styling: TailwindCSS
    - State Management: Zustand
    - Testing: Vitest + Testing Library
  </frontend_stack_defaults>

  <code_style>
    - Use TypeScript for all new files
    - Prefer arrow functions for components
    - Always include error handling
  </code_style>
</code_editing_rules>
Ponle límites a tu agente de código. Por defecto quiere ser exhaustivo y se pone a leer medio repo. Dile cuándo dejar de preguntar y cuánto leer:
<persistence>
- Do not ask the human to confirm or clarify assumptions,
  as you can always adjust later. Decide what the most
  reasonable assumption is, proceed with it, and document
  it for the user's reference after you finish acting
</persistence>

<tool_budget>
- Use a maximum of 5 file reads before starting to code
- Focus on the most relevant files first
- If you need more context, ask specifically what to examine
</tool_budget>
Si solo vas a probar una cosa, pasa tus tres prompts más usados por el optimizer y guarda los resultados como plantillas.
Recursos #
- GPT-5 Prompting Guide ➡️: la guía de OpenAI para tareas agentic, programación y control del comportamiento del modelo.
- Prompt Optimizer ➡️: encuentra contradicciones y formatos faltantes en tus prompts, dentro del Playground.
- Optimization Cookbook ➡️: ejemplos de antes y después.
- GPT-5 for Developers ➡️: seis tips de programación de OpenAI Developers en X.
Foto de Sean Sinclair ➡️ en Unsplash ➡️