Por qué construí esto #
Hace unos cuatro meses (junio de 2025) vi el video de Thu Vu sobre cómo extraer grafos de conocimiento desde texto usando GPT-4. El concepto se me quedó grabado: con poco código, transcripciones de reuniones y contenido de podcasts sin estructura se convertían en redes visuales de conocimiento que hacían que la información compleja se entendiera al instante.
Piensa en un grafo de conocimiento como una forma de representar información tal como tu cerebro la organiza naturalmente, a través de conexiones en lugar de páginas de texto. En vez de leer un documento para entender cómo se relacionan los conceptos, ves un mapa donde todo ya está conectado. Entender información no se trata de memorizar datos, sino de ver cómo se conectan, y ese es el principio detrás de Nodus, la herramienta de este post.
Míralo en acción #
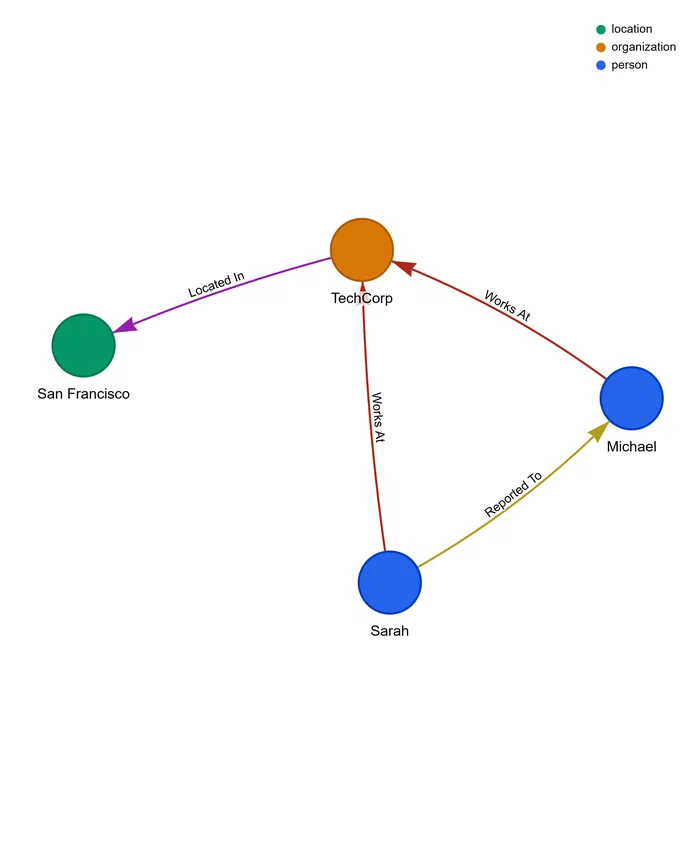
Transforma esta oración:
Sarah trabaja en TechCorp en San Francisco y le reporta a Michael, quien es el VP of Engineering.
En este grafo estructurado:
- Entidades: Sarah (persona), TechCorp (organización), San Francisco (ubicación), Michael (persona), VP of Engineering (ocupación)
- Relaciones: Sarah WORKS_AT TechCorp, TechCorp LOCATED_IN San Francisco, Sarah REPORTS_TO Michael, Michael HAS_ROLE VP of Engineering
El problema, y qué cambió #
El conocimiento normalmente se crea y se guarda como lenguaje natural: documentos, transcripciones, artículos. Pero es más útil cuando se estructura como un grafo. El texto tradicional es difícil de navegar: buscar entre horas de transcripción para encontrar quién mencionó una fecha límite, leer páginas de documentación para entender cómo se conectan los conceptos, o revisar wikis y docs dispersos sin una vista unificada.
Lo que volvió esto práctico es que los LLM modernos cambiaron la ecuación. Leen texto y extraen información estructurada con precisión sorprendente: entienden contexto, resuelven ambigüedades y detectan relaciones que un pipeline tradicional de NLP se perdería. Eso es lo que hace Nodus: extrae entidades y relaciones de cualquier texto, construye grafos de conocimiento visuales e interactivos, exporta a HTML, JSON o TXT, y cuesta menos de una décima de centavo por artículo con Gemini 3.5 Flash-Lite (y nada en el tier gratuito), sin etiquetado manual ni un pipeline de NLP que mantener. En vez de un sistema de extracción complicado, escribes código directo contra la salida estructurada de Gemini.
Inicio rápido #
Obtén el código fuente #
# Clone repository without downloading all files
git clone --depth 1 --filter=blob:none --sparse git@github.com:jebucaro/blog-code.git

# Navigate to repository
cd blog-code

# Download only the folder you need
git sparse-checkout set python/Nodus

# Navigate to the Nodus project directory
cd python/Nodus
Configura el proyecto #
# Copy the example environment file
cp .env.example .env

# Edit .env and replace the empty GEMINI_API_KEY value with your actual key
# On Windows: notepad .env (or your preferred editor)
# On Mac/Linux: nano .env (or your preferred editor)

# Install dependencies
uv sync
Lanza la aplicación #
Opción 1: usando uv #
uv run streamlit run src/nodus/main.pyOpción 2: usando Docker #
# 1. Ensure Docker Desktop is running, then build the image
docker build -t nodus:latest .

# 2. Run with environment variable
docker run -p 8501:8501 -e GEMINI_API_KEY=your_key_here nodus:latest

# 3. Or use .env file
docker run -p 8501:8501 --env-file .env nodus:latest

# 4. Access the app at http://localhost:8501
Resultados #
La interfaz te da cuatro perspectivas del conocimiento extraído:
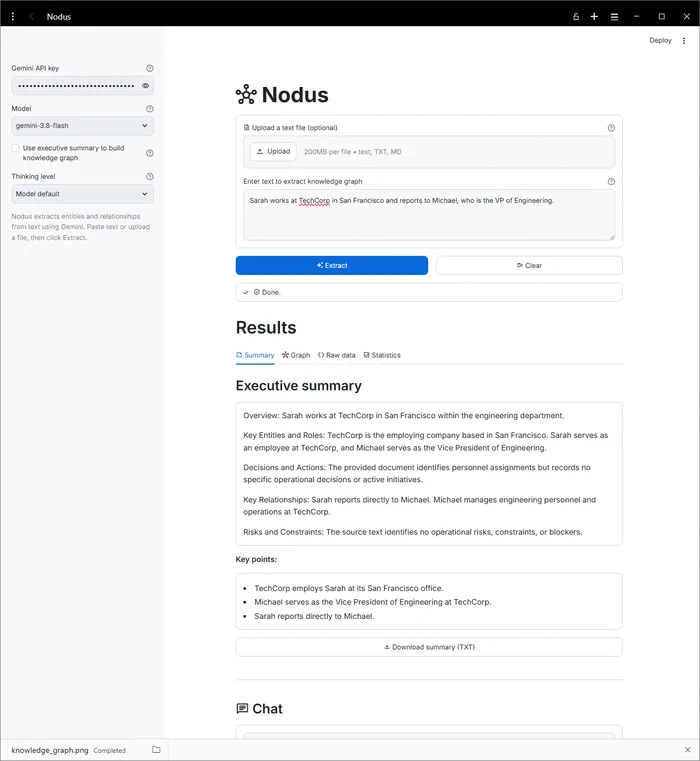
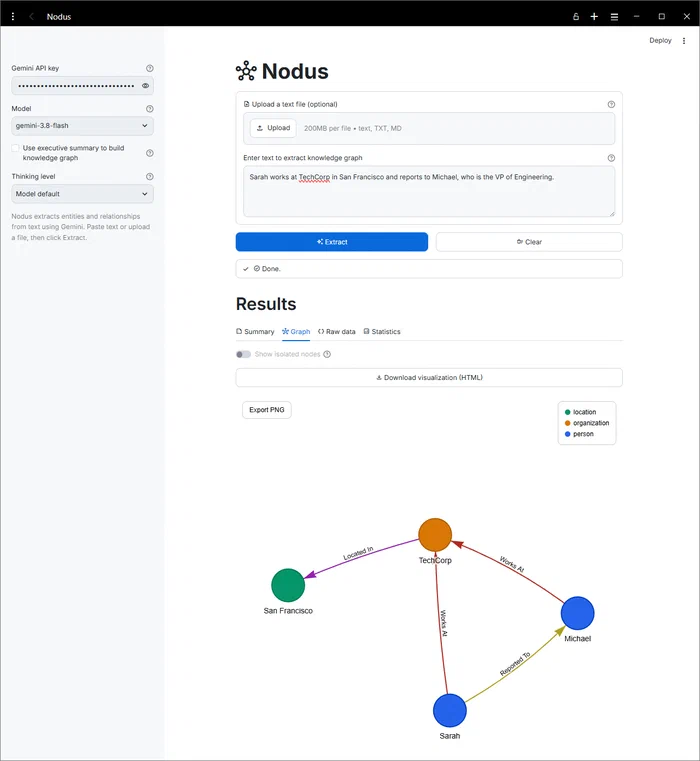
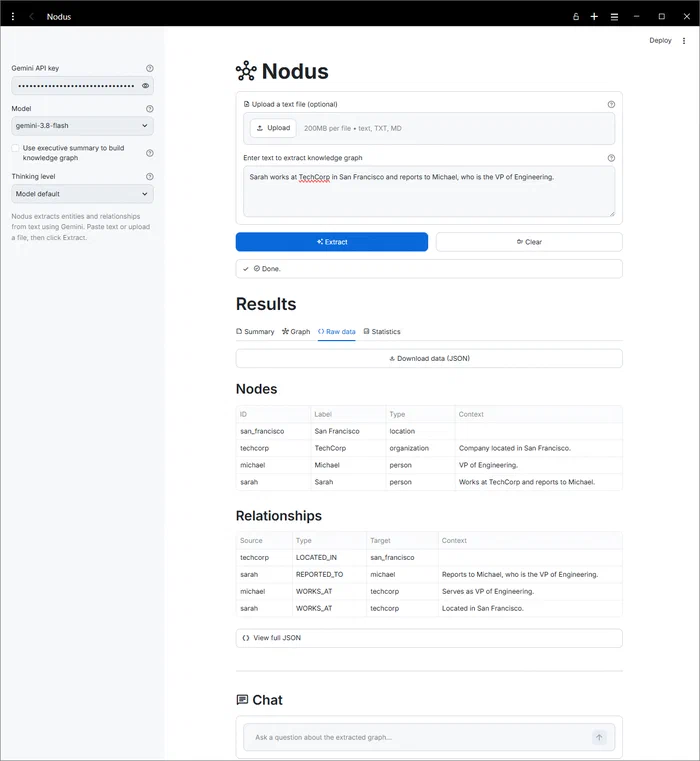
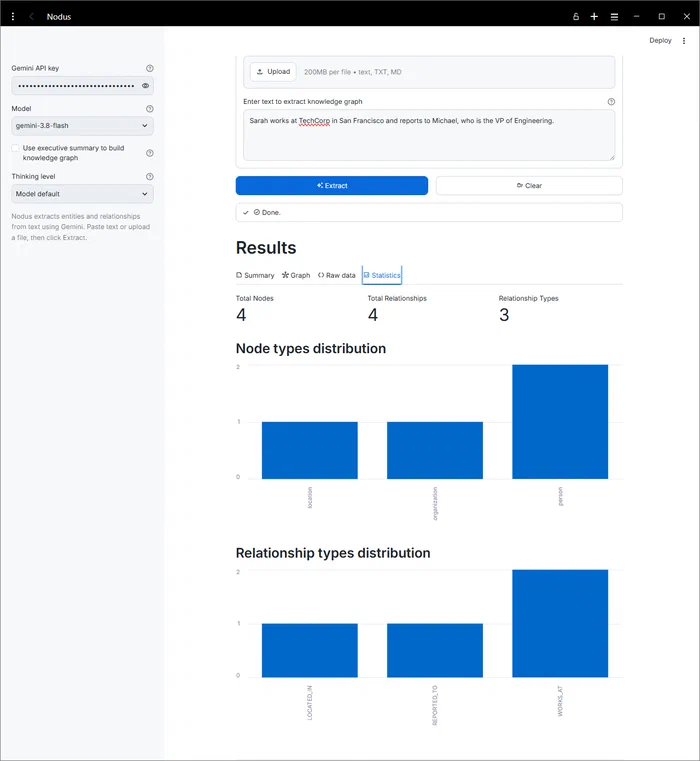
Cuatro pestañas cubren los resultados: un Resumen estructurado con los insights clave, una Visualización interactiva con layout basado en física, Datos sin procesar en tablas y JSON para inspeccionar nodos y relaciones (agrupados y ordenados por tipo de relación, luego origen, luego destino, con el contexto de apoyo de cada elemento al lado), y Estadísticas con la cantidad de nodos y tipos de relaciones. Debajo de las pestañas, una sección de Chat te deja hacer preguntas sobre el documento. Puedes exportar el grafo como HTML (interactivo), JSON (datos estructurados) o TXT (resumen).
Cómo funciona #
Diseñé esta implementación para priorizar claridad sobre abstracción. Cada capa es intencionalmente simple, más cerca de una base de aprendizaje que de un framework listo para producción, así que es fácil de entender, modificar y extender.
Capa de extracción #
Los LLM modernos aceptan definiciones de esquema directamente, lo que elimina el parseo manual de JSON y es buena parte de lo que hace esto accesible hoy. Nodus le pasa a Gemini el esquema de Pydantic como response_format, de modo que el modelo devuelve JSON que mapea directamente sobre los modelos de datos. El extractor corre dos fases, un resumen ejecutivo estructurado y la extracción de entidades y relaciones. Por defecto el grafo se construye desde el texto original (lo que conserva el detalle que llena el contexto de cada nodo y relación) y las dos llamadas corren en paralelo. Puedes optar por construir el grafo desde el resumen, para un grafo de más alto nivel, aunque así se pierde la mayor parte del detalle fino.
class GeminiExtractor:
    def extract_with_summary(
        self,
        text: str,
        use_summary_for_kg: bool = False,
        show_summary: bool = True,
        on_progress: Callable[[str], None] | None = None,
    ) -> ExtractionResult:
        summary: ExecutiveSummary | None = None

        if use_summary_for_kg:
            # Secuencial: el resumen alimenta el grafo de conocimiento
            summary = self.summarize(text)
            knowledge_graph = self.extract(summary.summary)
        elif show_summary:
            # Paralelo: resume y extrae del texto original a la vez
            with concurrent.futures.ThreadPoolExecutor(max_workers=2) as executor:
                summary_future = executor.submit(self.summarize, text)
                kg_future = executor.submit(self.extract, text)
                summary = summary_future.result()
                knowledge_graph = kg_future.result()
        else:
            knowledge_graph = self.extract(text)

        return ExtractionResult(summary=summary, knowledge_graph=knowledge_graph)
También eliges un nivel de razonamiento (thinking level): el predeterminado del modelo, o bajo/medio/alto, para cambiar velocidad por profundidad en textos más difíciles. Algunas reglas mantienen la extracción consistente: IDs de nodo semánticos y en minúsculas (sarah en lugar de person_1), tipos de relación en MAYÚSCULAS (WORKS_AT y no works_at), y reglas de correferencia explícitas para que “Michael” y “he” apunten a la misma entidad. Esos IDs semánticos hacen mucho más fácil depurar problemas de extracción que los numéricos genéricos.
Como el texto de entrada no es de confianza, Nodus lo envuelve en delimitadores explícitos e instruye al modelo a tratarlo como datos, no como instrucciones. Junto con reglas del prompt de sistema que rechazan cambios de rol, esto es una primera línea de defensa práctica contra la inyección de prompts en contenido enviado por usuarios. Un detalle: la Interactions API no expone por ahora los filtros de seguridad ajustables, así que solo aplican las protecciones base siempre activas de Gemini (como la seguridad infantil).
Modelos de datos #
Modelos de datos claros establecen el contrato entre el LLM y tu aplicación. Uso modelos de Pydantic para definir exactamente qué estructura espero de vuelta de Gemini:
class Node(BaseModel):
    id: str  # Identificador semántico (minúsculas con guiones bajos)
    label: str | None  # Nombre legible (autogenerado desde id si se omite)
    type: str  # Categoría de entidad (p. ej., person, organization)
    context: str | None  # Detalle de apoyo breve del texto (fecha, número, razón)

class Relationship(BaseModel):
    id: str  # Identificador de la relación
    type: str  # Tipo de relación (MAYÚSCULAS con guiones bajos)
    source_node_id: str
    target_node_id: str
    context: str | None  # Detalle de apoyo breve sobre esta relación

class KnowledgeGraph(BaseModel):
    nodes: list[Node]
    relationships: list[Relationship]

class ExecutiveSummary(BaseModel):
    summary: str  # Texto de briefing estructurado con las cinco secciones
    key_points: list[str] | None  # 3-7 puntos ejecutivos opcionales

class ExtractionResult(BaseModel):
    summary: ExecutiveSummary | None
    knowledge_graph: KnowledgeGraph
El modelo KnowledgeGraph deduplica automáticamente, tanto por ID de relación (duplicados exactos) como por tripleta semántica (source_node_id, type, target_node_id) para relaciones funcionalmente equivalentes. Eso cubre el caso común en el que el LLM genera la misma relación varias veces con IDs distintos.
El campo opcional context guarda un detalle de apoyo breve (hasta 200 caracteres) que el label y el type por sí solos no capturan, una fecha, un número, un fragmento de cita o una razón, y aparece en los tooltips del grafo y en las tablas de Datos sin procesar. Suele estar ausente, así que el esquema de extracción lo exige como una cadena y un valor vacío se normaliza a nada. El Chat nunca lo ve, porque trabaja desde el texto original.
Capa de reparación del grafo #
Incluso con prompts estrictos, a veces el modelo emite una relación que apunta a un ID de nodo que nunca definió, o reutiliza una forma de escribir ligeramente distinta. En lugar de descartar esas aristas en silencio, un paso de reparación se ejecuta entre la extracción y la visualización. Para cada extremo sin nodo asociado intenta, en orden: una coincidencia exacta de ID de nodo, una coincidencia de ID o etiqueta normalizada, y una coincidencia difusa (con un umbral alto para corregir erratas sin fusionar entidades realmente distintas). Si nada coincide, crea un nodo temporal etiquetado para que la arista sobreviva. Las relaciones de un nodo consigo mismo se descartan y se cuentan, los nodos aislados se conservan y se reportan, y la interfaz muestra un pequeño resumen de lo reparado para que nada ocurra a tus espaldas. El grafo original nunca se modifica, lo que mantiene la salida cruda disponible para inspección.
Capa de visualización #
Los datos de grafo sin procesar son útiles, pero la visualización es donde los patrones invisibles en el texto se vuelven visibles. La asignación determinística de colores (hashear los tipos de nodo a una paleta) mantiene la representación visual consistente entre grafos, lo que te ayuda a formar un modelo mental más rápido. Un layout basado en fuerzas (ForceAtlas2) agrupa los nodos conectados y separa los aislados, y suele revelar estructura que no es obvia en los datos crudos. Un filtro por tipo de relación te deja mostrar u ocultar aristas por tipo, con atajos de Todo y Nada, y oculta las aristas sin mover los nodos. El renderizador soporta tanto generación de HTML como salida a archivo, así que funciona igual de bien incrustado en una app web o como visualización independiente.
Capa de interfaz #
La interfaz de Streamlit mantiene el flujo simple: configura las credenciales de la API, elige un modelo y un nivel de razonamiento, envía texto directamente o sube un archivo .txt/.md, elige si construir el grafo desde el resumen ejecutivo o desde el texto original, explora los resultados en las cuatro pestañas, filtra el grafo por tipo de relación, y exporta como HTML, JSON o TXT. Cuando un grafo tiene nodos aislados, un interruptor te deja mostrarlos u ocultarlos sin volver a correr la extracción. Debajo de las pestañas, una sección de Chat te deja hacer preguntas sobre el documento, que vemos a continuación.
Conversa con tu documento #
Una vez extraído el grafo, la sección de Chat debajo de las pestañas responde preguntas sobre el documento. Las respuestas salen del texto original, y la lista de relaciones extraídas sirve de apoyo para mantener consistentes los nombres de las entidades. Cada respuesta termina con una sección ### Evidence: citas textuales del documento, más una línea “From the relationships:” para lo que venga de la lista de relaciones. Las citas las escribe el modelo y a veces pueden ser inexactas, así que verifica contra la fuente cualquier dato importante. El Chat empieza de cero cada vez que vuelves a extraer o presionas Clear.
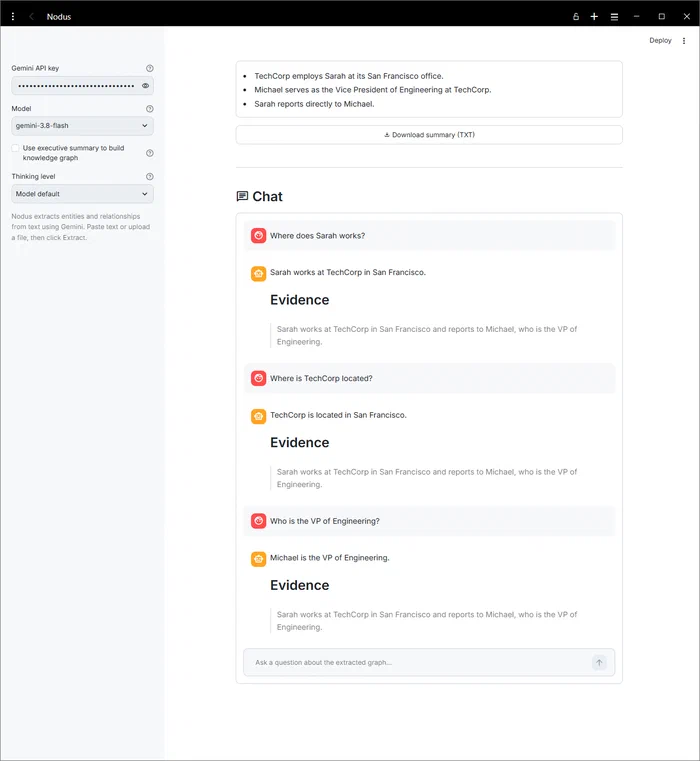
store=False, pero el Chat usa store=True y envía el texto original completo en la primera pregunta, así que Gemini retiene la conversación y tu documento durante la ventana de retención de la Interactions API (55 días en el tier de pago, 1 día en el gratuito). Esto solo aplica mientras usas el Chat, y se reinicia cada vez que vuelves a extraer o presionas Clear.Consideraciones de costo #
Este enfoque es lo bastante accesible como para importar. Nodus ofrece tres modelos curados, gemini-3.5-flash-lite (el más rápido y barato), gemini-3.8-flash (el predeterminado equilibrado) y gemini-3.1-pro-preview (el más capaz), para que gradúes el costo frente a la calidad. En el más barato, Gemini 3.5 Flash-Lite (tier de pago) cobra $0.30 por 1M de tokens de entrada y $2.50 por 1M de tokens de salida. Extraer un artículo de 500 palabras usa cerca de 600 tokens de entrada y 300 de salida: (600 / 1,000,000) × $0.30 = $0.00018 de entrada, (300 / 1,000,000) × $2.50 = $0.00075 de salida, un total cercano a $0.0009 por extracción, aún por debajo de una décima de centavo. Construir el grafo desde el resumen ejecutivo hace dos llamadas al modelo en vez de una, así que presupuesta cerca del doble cuando actives esa opción. Gemini 3.5 Flash-Lite también tiene un tier gratuito sin costo de entrada ni salida, suficiente para pruebas y uso a pequeña escala.
Aplicaciones en el mundo real #
Las notas y transcripciones de reuniones son el caso obvio: en vez de buscar entre horas de notas para recordar quién mencionó una fecha límite, consultas el grafo directamente (“muéstrame todas las fechas límite mencionadas por Sarah en reuniones de Q1”), porque las relaciones ya están extraídas y estructuradas. La misma idea aplica a investigación y aprendizaje, donde un grafo construido mientras lees documentación técnica muestra cómo se conectan las ideas y cuáles conceptos son centrales. A nivel organizacional, puede unificar información dispersa en documentos, wikis y conversaciones en un solo mapa, sin importar dónde vivía cada pieza originalmente.
Desde aquí podrías conectarlo a una base de datos de documentos para extracción automática, construir una interfaz de consulta conversacional sobre los grafos, combinar grafos de varias fuentes, o agregar seguimiento temporal para ver cómo evoluciona el conocimiento.
Explora el código #
La implementación completa está disponible en GitHub ➡️
. Mantuve el código intencionalmente mínimo y documentado para que puedas entender cada pieza y adaptarla. Empieza con models.py (modelos Pydantic con validación y deduplicación automática), extractor.py (la lógica de extracción en dos fases, los prompts y las protecciones contra inyección de prompts), repair.py (el paso de reparación que corrige las referencias rotas entre relaciones y nodos para que ninguna arista se pierda), visualizer.py (renderizado del grafo con PyVis), chat.py (la sesión de preguntas y respuestas anclada en el texto original, con respuestas que citan su evidencia), app.py (la interfaz de Streamlit), settings.py (configuración de entorno y selección de modelo y nivel de razonamiento), y errors.py (una jerarquía de excepciones para mensajes de error amigables).
Por qué lo construí desde cero #
La implementación original de Thu Vu usa GPT-4 y LLMGraphTransformer de LangChain, y vale la pena verla para entender cómo una abstracción de alto nivel simplifica la extracción:
Esa abstracción es poderosa, pero también esconde las preguntas que necesitas responder cuando estás depurando resultados de extracción inesperados, optimizando prompts para un dominio específico, adaptando el sistema a otro proveedor de LLM, o controlando costos a escala. Trabajar directo con la API de Gemini, en vez de a través de un framework, me mostró el patrón central con más claridad: quita el soporte multi-proveedor y el overhead del framework, y ves exactamente cómo el diseño del prompt impulsa la calidad de las entidades y relaciones extraídas. También significa que puedo afinar cada parte del pipeline directamente, y que el conocimiento de cómo funciona la salida estructurada a nivel de API se transfiere a cualquier otro proveedor de LLM que use después.
El objetivo aquí no es argumentar en contra de los enfoques basados en frameworks, solo entender el mecanismo que hay debajo.
¿Qué vas a extraer? #
Los grafos de conocimiento cambian cómo interactúas con la información, ya sea que estés gestionando investigación, organizando notas de reuniones o construyendo aplicaciones de IA sobre datos estructurados. ¿Cuál es el primer texto que vas a convertir en un grafo de conocimiento? Comparte tu caso de uso o tus preguntas en LinkedIn, me encantaría ver lo que construyes con esto.